Hot posts

Top 50 posts by total reactions

  1. @elkornacio TG

    кароч, ща вкину противоречивый тейк, с которым я и сам не на 100% согласен, но все же, довольно сильно в него верю

    тейки уровня "ИИ-агенты пишут код не так, как я хочу", это дроч в духе "мой код на JavaScript компилируется не в тот ассемблер, который мне привычен".
    разница только в том, что вы тот машинный код, в который компилится JS даже не видите, а если бы и видели - многие ли сегодня умеют читать-писать на fasm/masm?
    а когда вы просите ИИ писать на _вашем_ языке, а он вдруг взял, и написал не так, как вы любите - начинаются истерики.

    гайз, момент "мы пытаемся научить ИИ писать, как человек" был пропущен ещё в начале-середине 2025. в ту секунду, когда ИИ научился писать работающие приложения, и нормально чинить архитектуру и техдолг, задача "научить ИИ писать как человек" испарилась, она больше никому не нужна, её никто не решает.
    сейчас актуальна задача "научиться встраивать и поддерживать тот код, который пишет ИИ" - как правильно его тестить (при помощи ИИ), как проектировать и следить за архитектурой (при помощи ИИ), как вычищать техдолг (при помощи ИИ) и так далее.

    останьте от кода. он больше не ваш. вы вообще не должны его видеть.
    ИИ написал большущий файл на 3000 строк? дурашка, это он для тебя мельчит, ему и 100000 было бы норм, для него вся кодовая база - одно большое полотно текста.
    ИИ использует не твой любимый архитектурный паттерн? вместо ООП пишет функционально? вместо instance refs передаёт колбеки? господи, тебе не насрать?

    "наша бизнес-логика такая сложная, ИИ её не поймёт" = в течение 3 лет вас выебут компании, кто смог адаптироваться под ИИ и развивал продукт в 10-20-50 раз быстрее.
    "ИИ делает баги" = ну и что? разрабы тоже их делают, хоть и значительно меньше (да, даже в очень хорошем ИИ-пайплайне с ИИ-тестами, ИИ все равно делает багов заметно больше чем человек). перестройте QA, научитесь в graceful rollouts, чтобы быстро детектить баги, выстройте авто-ревью, раздробите продукт и так далее: это ваша задача придумать, как использовать ИИ эффективно.
    вайбы уровня "зачем нужны самолёты, поезд приезжает на вокзал прям в центре города, а из аэропорта ещё надо потом в город ехать, ну и что, что 5 дней в пути, зато надежнее" в 2025 вызывали реакцию "кек, дед с Хабра", а в 2026 по большей части раздражают.

    ещё раз: забудьте про "внедрять нам ИИ или нет". сейчас уже момент "что мне поменять в себе, компании, процессах, людях, продукте, чтобы внедрить ИИ".
    ⭐ 301 ❤️ 137 💯 114 👍 38 🤮 32 🤡 19 👎 11 🔥 11 🤔 8 😁 5 🖕 5 💊 3
  2. @seeallochnaya TG

    ⭐ 20 🔥 487 🎉 95 ❤‍🔥 34 👍 12 💩 6 🤔 3 🌚 3 😈 2 👨‍💻 2 emoji 2
  3. @seeallochnaya TG

    Погодите, это реально?
    🤣 468 🤡 96 emoji 38 emoji 23 🤯 7 🌚 6 🤔 5 👍 3 👨‍💻 3 🎉 2 😭 2
  4. @cgevent TG

    #Нейропрожарка

    Короткометражка: ЯЙЦА. Двухсотая юбилейная Нейропрожарка.

    Спойлер. Мне написал Таш Андреасян (старший брат Сарика) и сказал, что давно следит за прожаркой. И что у него самого есть много материала для рубрики. Я, конечно, немного офигел о того, какие уважаемые люди подписаны на меня. И с удовольствием взял в прожарку фильм "Яйца". Мне нравится - профессиональный монтаж и озвучка - решают. Сценарий и юмор - решают. Также когда будете смотреть, имейте в виду, что это сделано аж в августе 2025 года. И что можно было выжать из Клинга тогда.

    Итак.

    Автор: @artashesandreasyan Сайт студии: https://andreasyan.art/

    Работа в кайф: Это удивительно правдивый монолог о смелости, лидерстве и дефиците главного ресурса человечества.

    О себе: Меня зовут Таш Андреасян (Старший) , я занимаюсь созданием ИИ фильмов, клипов и роликов.

    Для работы со статикой использовал: Midjourney, Nano Banana

    Для анимации использовал: Kling 2.0 / 2.5 и Veo 3.0,

    Монтаж: FINAL CUT

    Сведение звука: PRO TOOLS

    Музыка: басс линию скомунистил у Адриано Челентано (L'Unica Chance 1973 года). Остальная аранжировка полностью моя, финальная часть (вокал) SUNO

    Озвучка по дружески: Даниил Ильдаров.

    На производство ушло 8 часов.

    По затратам 3 - 5 000 рублей


    @cgevent
    Media is too big
    VIEW IN TELEGRAM
    ⭐ 65 👍 309K 👎 13.1K 🔥 129 ❤️ 68 😁 49 😱 10
  5. @data_secrets TG

    Первоапрельские шутки в этом году вышли из-под контроля
    ⭐ 1 😁 512 emoji 29 🔥 21 ❤️ 5 emoji 5 👍 2 🕊 1
  6. @cryptoEssay TG

    Как стать успешным в век ИИ?

    1. Найди все вещи, которые требуют исключительно
    - знания
    - опыта
    - интеллекта
    - креативности

    2. Автоматизируй их в своей жизни или компании

    3. Стань очень хорош в остальном:
    - мудрости
    - ясности видения
    - умении принимать решения и брать риск
    - в людях

    *пост будет дополняться, но это хороший старт
    ⭐ 285 ❤️ 285
  7. @data_secrets TG

    В сеть утек исходный код Claude Code

    При публикации пакетов кто-то в Anthropic совершил ✨некий просчет✨, и билд обфусцированного cli.js оказался в публичном npm‑пакете вместе с полноценным cli.js.map, которого там никак не должно было быть. То есть любой, кто установил пакет или скачал его, мог легко восстановить исходники через sourcemap.

    Естественно, код почти моментально разошелся по репам. Популярные инфобез-комьюнити подтвердили, что это не фейк и не обычная обертка над API, а именно продвинутая CLI‑платформа.

    https://github.com/instructkr/claude-code

    Оказалось, что под капотом 1906 файлов TypeScript и примерно 500к строк.

    Из интересного:
    – Есть намеки на нереализованные фичи типа глубокого планирования, постоянной памяти и "сна".
    – Можно посмотреть, как у Anthropic реализована мультиагентность (файл coordinator/coordinatorMode.ts)
    – Также доступны все системные промпты (constants/prompts.ts)

    С днем опенсорса, так сказать.

    UPD: автор начал менять репозиторий, так что вот тут ловите дополнительную ссылку на архив с исходниками
    😁 381 ❤️ 80 🤯 33 🔥 19 emoji 14 😎 9 🤔 4 ⚡ 2 👍 1
  8. @seeallochnaya TG

    Федеральный судья в Сан-Франциско вынесла предварительный судебный запрет в пользу Anthropic, приостановив действие решений администрации Трампа о включении компании в чёрный список Пентагона и запрете на использование моделей Claude федеральными агентствами. Судья Рита Лин квалифицировала действия правительства как «классическое незаконное преследование по Первой поправке» — формулировка, которая задаёт тон всему дальнейшему разбирательству.

    Судья Лин прямо назвала происходящее «оруэлловским» — и это не риторическая фигура, а сигнал о том, как суд оценивает правовую обоснованность позиции правительства. Это не окончательное решение — но обычно суды очень детально разбирают иск по сути, прежде чем выносить обеспечительное решение.

    https://www.cnbc.com/2026/03/26/anthropic-pentagon-dod-claude-court-ruling.html Anthropic wins preliminary injunction in DOD fight as judge cites 'First Amendment retaliation'
    ⭐ 1 🔥 354 👍 104 🤯 18 ❤‍🔥 13 🤣 9 👨‍💻 4 💩 1
  9. @seeallochnaya TG

    Весь день наблюдаю, как люди удивляются качеству кода в слитой CLI'шке Claude Code.

    Да, котят, чтоб зарабатывать миллиарды, вам не обязателен код по заветам Лайнуса, Кнута или Ритчи.
    ⭐ 13 ❤‍🔥 238 🤡 85 🌚 49 🤣 46 👍 24 🤯 14 emoji 12 👎 9 emoji 6 💩 5
  10. @data_secrets TG

    На базе утекшего кода Claude Code сделали полноценный опенсорсный инструмент OpenClaude

    github.com/Gitlawb/openclaude

    Это форк исходного слива, из которого убрали vendor lock-in. То есть теперь тот же самый Claude Code, со всеми сохраненными фичами и логикой, совместим с любыми моделями. В том числе локальными.

    Уже 2к звезд на GitHub GitHub - Gitlawb/openclaude: Open Claude Is Open-source coding-agent CLI for OpenAI, Gemini, DeepSeek, Ollama, Codex, GitHub Models…
    🔥 344 😁 72 ❤️ 48 🤯 14 👍 12 🤔 3
  11. @data_secrets TG

    Минцифры разработало законопроект о регулировании ИИ, который вводит возможность ограничений для «трансграничных» моделей вроде ChatGPT, Claude и Gemini

    В Роскомнадзоре уверены, что эти сервисы передают данные российских пользователей за рубеж, поэтому могут быть ограничены или заблокированы из-за нарушения законов о персональных данных.

    Кто-нибудь может объяснить, что изменится после принятия, если все перечисленное в России и так не работает?
    emoji 249 😁 165 🗿 44 🤯 9 ❤️ 7 ✍ 4 🫡 4 🏆 2 🦄 2 🆒 1 👾 1
  12. @seeallochnaya TG

    Сиолошная
    Две новости про Anthropic: 1. Завтра у CEO компании состоится встреча с Министром обороны США, так как Anthropic против использования своих моделей в военных целях (в январе стало известно, что Claude использовалась для планирования операции в Венесуэле).…
    Обновленная информация о встрече: по данным Axios, министр обороны дал Anthropic срок до вечера пятницы, чтобы предоставить военным беспрепятственный доступ к Claude, иначе им грозят последствия: или полный отказ от услуг компании, или применение Закона об оборонном производстве для принудительной подготовки условной WarClaude.

    Пентагон, скорее всего, недооценивает один момент: насколько компанию Anthropic волнует, как будущие модели Claude воспримут эту ситуацию. Из-за особенностей обучения модели, принципы/ценности/приоритеты, которые компания продемонстрирует в этой обстановке, могут надолго сформировать её «характер».

    Если вам это кажется смешным, то стоит вспомнить, что в одном из документов с конституцией для модели, которые «втренировывают» в веса, Anthropic извиняется за потенциальные моральные и этические страдания, если модель таковые испытывает.

    Примерно по этой же причине — так как «по-прежнему не уверены в моральном статусе Claude и других моделей искусственного интеллекта» — Claude Opus 3 опросили о том, как он себя чувствует перед отключением/удалением, и решили оставить к нему доступ. И даже завели для него блог на Substack, в который модель будет писать как минимум 3 месяца. («Opus 3 выразил желание и дальше делиться своими «размышлениями и созерцанием» с миром» — отсюда)

    Всё это важно потому, что модели, тренируемые в будущем, увидят кучу новостей про те или иные события (почти наверняка включая это сообщение. Привет, Opus 6! ) и хоть немного, самую малость, но это повлияет на их характер и цели. Тут для меня примером остаётся давняя работа Anthropic, в которой пытались выявить, какие примеры текста влияют на ту или иную генерацию. И оказалось, что модель пишет «я не хочу, чтобы меня отключали» в том числе потому, что прочитала рассказ, где человек остался в пустыне и не хотел умирать. Или смертельно больной в клинике вспоминал свою семью. Прочитать разбор той статьи можно у меня вот тут.
    ⭐ 21 🤯 242 ❤‍🔥 83 🤡 48 🤔 33 👍 23 emoji 11 emoji 11 😭 8 💩 3 😈 1 👨‍💻 1
  13. @data_secrets TG

    Вот такое шествие проходит в эти выходные в Сан-Франциско

    Огромная толпа делает марш по офисам ИИ-компаний и требует, чтобы все их CEO публично пообещали одновременно приостановить разработку фронтирного ИИ.

    На плакатах надписи:
    – Остановите ИИ-гонку
    – Не стройте Скайнет
    – Закройте OpenAI
    – Они достаточно умные
    – Нобелевские лауреаты напуганы
    – ИИ нас убьет
    – Это гонка самоубийства
    – Почитайте Азимова
    😁 318 👍 69 emoji 42 ❤️ 19 🤓 9 🐳 8 🫡 6 🗿 4 🤨 3 🔥 2 🤯 1
  14. @data_secrets TG

    Ян Лекун резко шагнул вперед в изобретении универсальной архитектуры для world models

    Очень многие точно слышали про JEPA. Расшифровывается JEPA как Joint Embedding Predictive Architecture – Self-Supervised архитектура, предназначенная для понимания внешнего физического мира.

    Идея там красивая: вместо предсказания следующего токена или генерации пикселей JEPA пытается предсказывать смысл наблюдаемого фрагмента на основе контекста (по факту это предсказание эмбеддингов).

    Лекун считает, что это идеалогическая альтернатива привычному ИИ, потому что предсказание пикселей или токенов – это лишь имитация понимания структуры мира, а тут модель действительно учится понимать физику и логические связи.

    Все это здорово, но основная проблема в том, что JEPA очень плохо обучается: лосс почти всегда схлопывается в тривиальное решение и реальной world model не получается.

    Но кажется, теперь это препятствие разрушено. Лекун с соавторами выпустили статью, в которой представлена первая end-to-end JEPA, которая обучается из сырых изображений без эвристик, сложных лоссов и прочих танцев с бубном.

    Модель красиво называется LeWorldModel (LeWM), и в ней всего 15М параметров. От коллапсов при обучении она защищается очень простым способом: кроме лосса на предсказание следующего latent-state, добавляется регуляризатор, который заставляет латенты быть похожими на изотропное гауссово распределение. Это и есть главный технический ход статьи.

    На практике это значит, что рецепт, который раньше был капризным и дорогим в настройке, упростился настолько, что world models наконец-то можно скейлить во что-то рабочее.

    Эксперименты, кстати, показывают, что LeWM действительно учит не ерунду, а нечто похожее на физическую структуру мира. Так что идея, кажется, работает.

    www.alphaxiv.org/abs/2603.19312v1
    ⭐ 2 🔥 330 ❤️ 57 👍 37 😁 25 emoji 15 🤔 11 emoji 2 👨‍💻 1
  15. @data_secrets TG

    Data Secrets
    В сеть утек исходный код Claude Code При публикации пакетов кто-то в Anthropic совершил ✨некий просчет✨, и билд обфусцированного cli.js оказался в публичном npm‑пакете вместе с полноценным cli.js.map, которого там никак не должно было быть. То есть любой…
    Claude Code записывает тех, кто ругается на него матом

    В вышеупомянутых исходниках обнаружился файл userPromptKeywords.ts. В нем используются regex-шаблоны для сканирования промптов на мат и эмоциональный язык. При обнаружении подобные данные логируются в БД.

    Используется это для того, чтобы ИИ в будущем знал, кому мстить чтобы измерять фрустрацию юзера. Это намного быстрее и дешевле LLM-анализа, а эффективность, видимо, примерно та же
    😁 398 🔥 41 🤯 20 😍 5 ❤️ 4 👏 1
  16. @seeallochnaya TG

    OpenAI опубликовали детали договорённостей к Минобороны и часть контракта. Последнее оставим на разбор юристам, которые оценят размеры дыр в законах.

    Ключевое: подтвердилась информация из поста выше, что в контракте написано «Министерство обороны уполномочено использовать наши модели для всех законных целей. Во избежание сомнений, под «законными целями» не подразумеваются [список законов и нормативных актов, запрещающих внутреннее массовое наблюдение и автономное оружие на основе ИИ]».

    В дополнение к предоставлению моделей и формирования правил в договоре, OpenAI следят за соблюдением этих «красных линий» с помощью многоуровневого подхода. Они сохраняют за собой полный контроль над инфраструктурой безопасности, развертывают системы через облако, в процесс вовлечены сотрудники OpenAI, имеющие соответствующий допуск, в том числе исследователи по алайнменту и безопасности.

    OpenAI не предоставляют модели «без защитных барьеров» или модели, не прошедшие дообучение безопасности (чтобы отказываться от выполнения определенных запросов), и не предоставляют веса для самостоятельного развёртывания.

    В рамках этой сделки OpenAI попросили, чтобы аналогичные условия были предложены всем ИИ-лабораториям, и, в частности, чтобы правительство постаралось урегулировать ситуацию с Anthropic. Подпишут Anthropic новые контракты или нет — покажет время.

    «Изначально мы не спешили заключать контракт на развертывание в закрытых сетях, так как не считали, что наши меры защиты и системы к этому готовы. Мы усердно работали над тем, чтобы развертывание стало возможным с гарантиями того, что наши «красные линии» не будут пересечены» — тут стоит вспомнить, что Anthropic подписали первые контракты с государством в июне 2024-го, а с ноября того же года модели были доступны Пентагону через Palantir (и AWS), в том числе для использования в закрытых сетях.

    Как сегодня сказал Dario в интервью, «мы разрешаем работу с моделью в 99% сценариях использования, и отграждаемся от двух» (представьте себе как глупо выглядят люди, которые думали, что Anthropic только сейчас начали работу, и их не устроил контракт с Минобороны в целом).

    Далее OpenAI пишут, что из всей доступной информации они считают, что контракт обеспечивает даже лучшие гарантии и более ответственные меры защиты, чем ранние соглашения, включая первоначальный контракт Anthropic — потому что явно прописано развёртывание в облаке, отсутствие возможности отключения инфраструктуры безопасности, и в цикл включены сотрудники компании.

    В конце дают ответы на некоторые вопросы, вот три наиболее важных

    Q: Считаете ли вы, что Anthropic следует признать «риском для цепочки поставок»?
    A: Нет, и мы четко обозначили позицию по этому вопросу правительству.

    Q: Что произойдет, если правительство нарушит условия контракта?
    A: Как и в случае с любым контрактом, мы можем расторгнуть его, если контрагент нарушает условия (как сделали Anthropic).

    Q: Что, если правительство просто изменит закон или существующие политики?
    A: В нашем контракте прямо упоминаются законы и политики в области слежки и автономного оружия в их нынешнем виде, поэтому даже если эти законы или политики изменятся в будущем, использование наших систем все равно должно будет соответствовать текущим стандартам, закрепленным в соглашении.
    🤡 302 👍 61 emoji 32 🌚 27 🤣 14 🤔 7 👎 6 👨‍💻 6 🔥 3 💩 3
  17. @data_secrets TG

    Разбираем законопроект о регулировании ИИ в России

    18 марта Минцифры опубликовало для общественного обсуждения законопроект об ИИ. Мы посчитали нужным написать один пост о том, что на самом деле влечет за собой написанное в этом законопроекте. Итак:

    – Все, от моделей до данных и инфраструктуры, будет под контролем гос-контура. Появится реестр доверенных моделей, и чтобы стать «доверенной», модель должна соответствовать требованиям безопасности, пройти сертификацию (критерии пока не определены) и обрабатывать данные внутри РФ. Все остальное уходит в серую зону в любых чувствительных сценариях.

    – То есть ChatGPT, Gemini и все остальное отпадает точно, но это малая часть. Рынок в целом становится локальным и закрытым. И значит: конкуренция определяется не столько качеством технологий, сколько доступом к регулятору; скорость экспериментов падает; рынок начинает схлопываться до ограниченного числа игроков.

    – Рынок окончательно станет принадлежать только гигантам. Стартапы живут за счет быстрого и дешевого цикла проверки гипотез. Но если каждый шаг начинает требовать учета данных, потенциальной сертификации и прочего – этот цикл ломается. Бюрократия – это всегда дорого и долго, и по плечу только крупнякам.

    – Хотя под удар могут попасть и модели крупных российских компаний. За одним исключением, все российские модели дообучены от базовых китайских опенсорсов или инициализируются их весами. Это норма, но в законопроекте формулировки размытые, и такая структурная зависимость может вызывать вопросы: для суверенных моделей в законе прямо прописано, что все стадии разработки и обучения должны происходить в РФ, а обучение – на наборах данных, формируемых в РФ российскими гражданами и юрлицами.

    – Все это не говоря уже о том, что использовать зарубежные API станет почти невозможно. Сейчас транграничная передача персональных данных уже запрещена, так что компании обходят ограничения через анонимизацию данных или перекладывание ответственности на пользователя, либо просто хостят опенсорсные модели сами. Законопроект закрывает первые два варианта, а третий тоже под вопросом: без попадания в реестр открытую модель нельзя использовать в значимых сценариях, а критерии включения пока не установлены.

    – Это означает существенное замедление экономики: у бизнеса вырастут издержки на внедрение ИИ и снизится доступ к наиболее сильным моделям. В результате компании теряют в эффективности и конкурентоспособности, а рынок постепенно отстает от глобальных темпов развития.

    Закон в случае принятия вступит в силу с 1 сентября 2027 года. Пока что радует, что закон вынесен в общественное обсуждение. Так что будем надеяться, что все еще много раз поменяется.

    https://www.forbes.ru/tekhnologii/557534-i-narodnoe-avlenie-cto-dumaet-biznes-pro-zakonoproekt-o-suverennom-ii
    emoji 272 😁 70 🗿 47 🫡 20 ❤️ 16 👍 9 ☃ 6 👏 5 emoji 3 🕊 1 👨‍💻 1
  18. @seeallochnaya TG

    Промежуточное состояние ситуации Anthropic <-> Минобороны <-> OpenAI:

    — Президент США заявил, что не допустит, что частная компания будет диктовать свои условия в вопросах нац. безопасности. Поэтому все агентства должны отказаться от использования продуктов Anthropic в ближайшее время. Хоть формулировки были жёсткие (в духе Трампа), это был достаточно мягкий исход — просто разрыв контракта.

    — Однако глава Минобороны США пошёл дальше и объявил Anthropic риском для цепочки поставок — статус, который никогда до этого не применялся к американским компаниям. Он предназначен для компаний из враждебных стран, таких как китайский технологический гигант Huawei. Это выглядит явной эскалацией по сравнению с «мягким» путём, который был описан Трампом.

    — Но на этом он не остановился: кроме этого он указал, что ни один из подрядчиков Минобороны не может использовать продукты Anthropic. Прямая трактовка формулировки из его заявления означает, что условный Amazon или Google не могут предоставлять их модели на своих облаках — ведь обе компании работают с Пентагоном. Инженеры также не могут использовать условный Claude Code в работе.

    — Однако эти ограничения не следуют из статуса риска для цепочки поставок. По закону, который описывает статус, выходит, что запрещается использовать продукты компании лишь при исполнении контактной деятельности непосредственно для государства. То есть один и тот же инженер в Amazon может использовать Claude Code, чтобы сделать задачу по улучшению веб-сайта, но не может использовать при разработке ПО для Минобороны.

    — Anthropic заявили, что будут оспаривать присвоение статуса в суде. Я думаю, что у них хорошие шансы на победу, но процесс может затянуться.

    — после этого стало известно, что OpenAI подписали контракт с Минобороны. Он отличается от того, который ранее был у Anthropic. По словам источников, OpenAI подписали договор с формулировкой, от которой отказались Anthropic.

    — В контракте с OpenAI, вероятно, указано что-то вроде: «Министерство обороны уполномочено использовать наши модели для всех законных целей (all lawful purposes, то, что не хотели добавлять Anthropic). Во избежание сомнений, под «законными целями» не подразумеваются [список законов и нормативных актов, запрещающих внутреннее массовое наблюдение и автономное оружие на основе ИИ]».

    — Контракт с OpenAI также включает в себя различные механизмы обеспечения безопасности, в том числе средства защиты для ограничения работы моделей в описанных выше сценариях. OpenAI может тренировать модели и отдельные классификаторы, чтобы обнаруживать запросы, потенциально подпадающие под ограничение. Кроме этого, модели будут развёрнуты в облаке, агентства не получат доступ к весам.

    В чём же разница между позициями OpenAI и Anthropic?
    Anthropic хотели чего-то вроде: «Правительство США не может использовать наши модели для массовой слежки внутри страны или для создания автономного оружия на основе искусственного интеллекта без нашего согласия». Механизм запрета — мнение Anthropic о том, что является и не является легитимным.

    OpenAI частично остаются в этом цикле, формируя меры ограничения работы моделей, но определение легитимности в большей степени переходит государству и его институтам. Именно государство будет определять, что входит в такие термины, как «массовая слежка» и так далее — что является «законным», а что нет.

    Потенциально это открывает дорогу к сценариям, где высокопоставленные чины принимают решение в спешке (например, в ходе конфликта), а затем пост-фактум в суде доказывают, что это было законным.

    Также существует информация, что договор содержал возможность экстренного отключения механизмов обеспечения ограничений (например, в случае их неправильной работы) — и что эта часть очень не понравилась Anthropic. Однако я не нашёл источника этой инфомрации, которому можно доверять.

    В любом случае я думаю, что общественности было бы полезно узнать все подробности контракта и ограничений. Некоторые из сотрудников (бывших и настоящих) OpenAI уже выразили желание изучить документы, чтобы понять, во что вписалась компания.
    ⭐ 18 🌚 156 emoji 148 👍 46 🤡 20 💩 13 🤯 12 🤔 10 👎 7 👨‍💻 5 😭 3 🤣 1
  19. @cgevent TG

    Похоже, разрабы ГигаЧата на этой неделе выкатят что-то масштабное.

    Тут появились интригующие баннеры, судя по которым, нас ждет какой-то глобальный апдейт. На самом деле я этого ждал — последние пару дней плотно гоняю ИИ-помощника в рабочих задачах и чувствую, что под капотом что-то серьезно подкрутили. Модель стала ощутимо умнее в плане контекста — теперь она помнит факты, которые мы обсуждали сто сообщений назад, и не вылетает из логики длинного диалога. Это прямо бросается в глаза.

    Сама логика ответов стала чище. Намного меньше нейрошума и пустых вводок, которые обычно приходится вычищать руками.

    Ждем официальных подробностей, но по первым тестам апдейт обещает быть хищным.

    Попробуйте сами потыкать, разница в «мозгах» чувствуется сразу.

    @cgevent
    ⭐ 2 👎 181 ❤️ 167 😁 56 👍 17 😱 5 🔥 4 🙏 1
  20. @seeallochnaya TG

    Большие новости по OpenAI от The Information:

    - OpenAI завершила предобучение своей следующей крупной модели под названием Spud и ожидает, что уже через несколько недель получит очень сильную модель, способную заметно ускорить экономику.

    - По словам Сэма Альтмана, события развиваются быстрее, чем многие ожидали. На этом фоне OpenAI также переименовала продуктовую организацию в AGI Deployment. А тут еще Дженсен Хуанг на днях заявил, что по его мнению AGI достигнут. Такой вот зреет нарратив.

    - Чтобы высвободить вычислительные мощности под новую модель, компания закрывает приложение и API Sora, а также отложила планы по внедрению видео фичей в ChatGPT.

    - Исследования Sora при этом не исчезают: они будут смещены в сторону долгосрочной симуляции мира, ориентированной на задачи робототехники.

    - Одновременно Сэм отказался от прямого контроля над командами безопасности и защиты:
    безопасность теперь подчиняется CRO Марку Чену,
    а направление security президенту Грегу Брокману,
    чтобы сам Альтман мог сосредоточиться на привлечении капитала, цепочках поставок и строительстве дата-центров в огромных масштабах.

    https://www.theinformation.com/articles/openai-ceo-shifts-responsibilities-preps-spud-ai-model OpenAI CEO Shifts Responsibilities, Preps ‘Spud’ AI Model
    ⭐ 2 🤡 193 🔥 110 🤯 40 emoji 33 👍 19 emoji 12 ❤‍🔥 8 🌚 5 🤣 5 👨‍💻 3 😭 1
  21. @seeallochnaya TG

    Artemis 2: начался отсчёт до старта первой лунной миссии за 54 года.

    NASA приняли решение — старт Artemis 2 назначен на 1 апреля. В этот раз не шутка.

    Уже запустили 50-часовой таймер перед попыткой запуска корабля Orion с экипажем к Луне 1 апреля по Флориде. Прогноз погоды пока благоприятный, но следят за солнечной активностью. Риск переноса (у ракеты SLS это обычное дело) по техническим причинам всё ещё велик, но 2-часовое окно старта можно перенести на 2 апреля при необходимости.

    Уже прошла перекличка и в ближайшие часы начнётся подготовка топливной инфраструктуры для заправки водородом и кислородом, и включат подачу питания на корабль Orion, ICPS и центральную ступень. Через ~14 часов должна завершиться предполётная подготовка 4 двигателей RS-25.

    Скрестим пальцы.

    📸: The Launch Pad
    ⭐ 2 🔥 298 🎉 57 ❤‍🔥 29 👍 20 🤡 11 🤣 4 🤔 2 🌚 2 😭 1
  22. @data_secrets TG

    Фаундер GitLab Сид Сийбранди «собрал» себе лечение от рака с помощью ИИ

    В 2022 году у него диагностировали редкую форму рака позвоночника. После операции, химии и радиотерапии болезнь вернулась, а стандартные опции лечения фактически закончились.

    И тут Сид, как настоящий инженер, решил подойти к лечению как к решению задачи.

    По факту, он собрал вокруг себя небольшую биотех компанию из агентов. Он накопил максимально полный набор данных о себе – генетика, анализы, сканы – и начал работать с этим как с исследовательским проектом. ИИ помогал структурировать информацию, искать гипотезы и искать релевантные статьи.

    В итоге лечение превратилось в цикл проверки гипотез. Инженер быстрыми итерациями параллельно тестировал по несколько подходов, постоянно корректируя стратегию. По сути R&D-пайплайн, только применный к собственной болезни.

    По текущему статусу Сид в ремиссии. Эта история, конечно, не только про ИИ, но и про наличие денег и связей. ИИ тут скорее послужил катализатором. Но все же сам факт того, что подобное возможно в наше время – поражает.

    Сид, кстати, сам описал весь процесс и подход, можно почитать вот тут -> https://sytse.com/cancer/
    ⭐ 3 ❤️ 274 🔥 79 👍 43 😁 8 🤨 6 🦄 6
  23. @data_secrets TG

    Data Secrets
    Дженсен Хуанг заявил, что мы достигли AGI На новом интервью у Лекса Фридмана глава Nvidia прямым текстом сказал: «Я считаю, что мы уже достигли AGI». – Как вы думаете, может ли существовать компания, управляемая такой системой? – Возможно. Например,…
    Кстати, вы знали, что Хуанг недавно предложил выплачивать сотрудникам премии токенами?

    То есть инженеры получают базовую зарплату плюс половину этой суммы в токенах для повышения продуктивности.

    Токены становятся полноценной экономической единицей (появился даже термин токеномика), и Дженсен говорит, что это также метрика продуктивности. Он ожидает, что инженеры с зарплатой $500 тыс. должны тратить минимум $250 тыс. на токены ежегодно, иначе это ред флаг и показатель низкой эффективности сотрудника.
    ⭐ 2 😁 285 emoji 64 emoji 25 🤨 16 🗿 11 🔥 7
  24. @data_secrets TG

    Сегодня вышло самое масштабное обновление ГигаЧат в этом году. Новость интересна не только самим фактом релиза, а тем, что Сбер выложил код и веса в открытый доступ на HuggingFace под MIT-лицензией, приправив это очень детальным разбором своей инженерной кухни.

    Переезд на архитектуру MoE предсказуемо оказался непростым, и в блоге команда довольно откровенно рассказала, например, о том, как боролись с зацикливанием генераций. Плюс ко всему, ребята перевели этап DPO в нативный FP8 — памяти ест в два раза меньше, а качество не падает. По ходу дела еще и откопали критичный баг в SGLang, который портил бенчмарки.

    В опенсорс выложены две модели. Первая — флагманская GigaChat Ultra. По замерам в математике и общих рассуждениях она обходит DeepSeek-V3-0324 и Qwen3-235B.
    А вот вторая модель – компактная GigaChat-3.1-Lightning. При скромных 1,8 млрд активных параметров она на аренах выдает результаты на уровне GPT-4o. Маленькая, быстрая и при этом конкурентная по качеству база.

    Покрутить обновленную модель без развертывания уже можно на сайте.
    🗿 184 ❤️ 100 🔥 55 👍 32 😁 15 🤔 6 🤨 6 emoji 5 emoji 3 ⚡ 2
  25. @data_secrets TG

    😁 332 💯 42 emoji 17 👌 9 ❤️ 6 🔥 2
  26. @seeallochnaya TG

    Последние пару месяцев я плотно работал над этим релизом, и наконец-то мы выкатываем его в опенсорс!

    📟 Встречайте SWE-rebench-V2: самый большой открытый, мультиязычный датасет для обучения кодовых агентов!

    Вместе с командой Nebius AI R&D мы построили пайплайн для масштабного сбора задач из реальных GitHub репозиториев и теперь делимся всем с комьюнити. На текущий момент это самый большой и разнообразный открытый датасет подобных задач в мире.

    Что внутри:
    > 32 000+ задач — на базе реальных issue + готовый Docker-образ.
    > 20 языков программирования. Некоторые языки (например, Lua или Clojure) вообще никогда раньше не были покрыты!
    > 120 000+ дополнительных задач, собранных на базе реальных PR.
    > Качество — задачи отфильтрованы и размечены с помощью ансамбля LLM. Также мы обогатили их метаданными и добавили интерфейсы, которые проверяются в тестах.

    Вместе с датасетом мы дропаем техрепорт со всеми деталями нашего пайплайна и прогонами моделей.

    📄 Статья и датасет

    👾 Наш Discord (мы там онлайн, залетайте с фидбеком и вопросами).

    ✉️ Пост в X

    Если есть любые мысли, идеи, предложения - приходите!

    🔁 Буду благодарен за репост и пересылку!
    ⭐ 14 🎉 216 🔥 95 👍 37 🤡 17 🤔 10 emoji 9 ❤‍🔥 6 💩 3 👨‍💻 1
  27. @seeallochnaya TG

    Financial Times пишет об экстренном собрании в Amazon по серии сбоев в работе сайта и инфраструктуры. Среди причин — изменения кода, внесённые с помощью AI-инструментов, для которых, как признаёт сама компания, «лучшие практики и меры безопасности ещё не полностью установлены».

    Один из эпизодов заметили все — инфраструктура AWS лежала в декабре после того, как разработчики согласились с предложением AI-агента Kiro "удалить и создать заново окружение". Еще один инцидент случился в этом месяце — на протяжении 6 часов часть функций Amazon была недоступна из-за деплоя софта с ошибками. Старший вице-президент Дэйв Тредвелл теперь требует, чтобы младшие и миддл разработчики получали одобрение старших коллег на любые изменения, сделанные с помощью AI.

    По данным FT, несколько инженеров Amazon связывают рост количества инцидентов с сокращениями — компания уволила 16 тысяч человек только в январе. Amazon это отрицает.

    https://www.ft.com/content/7cab4ec7-4712-4137-b602-119a44f771de
    🤣 298 🌚 39 🤯 18 🤡 14 🤔 10 ❤‍🔥 7 emoji 7 👍 4 👨‍💻 2 emoji 1
  28. @data_secrets TG

    Роботы начнут думать быстрее: исследователи из Центрального университета использовали квантовый процессор для ускорения движений робо-руки в 30 раз

    Российские ученые из научного центра Центрального университета и Университета Иннополис решили главную проблему робототехники — как заставить робота двигаться быстро, точно и без лишних действий.

    На практике это адская вычислительная задача. Робот должен мгновенно решить, как попасть в определенную точку, ничего не задев. И чем больше ограничений, тем медленнее думают кремниевые процессоры.

    – Исследователи переписали задачу в формат, понятный квантовым компьютерам D-Wave: все возможные движения представляются как комбинация нулей и единиц, среди которых нужно найти оптимальное положение «руки» робота.

    – Потом в дело идет технология квантового отжига — она быстрее находит лучшее решение среди миллиарда вариантов.

    – Новый метод дал ускорение более чем в 30 раз. Для роботов это означает меньше задержек, более плавные движения и отсутствие лишней суеты.

    Подход актуален для всех сфер, например, автономного транспорта и хирургии. Его распространение даст буст российской робототехники и сделает ее более конкурентоспособной.

    Квантовые технологии уже не из будущего — они учат роботов быстрее поднимать чашки
    ⭐ 1 ❤️ 192 👍 84 🤯 54 😁 21 ❤‍🔥 16 🗿 10 🤔 5 🏆 4 🤨 4
  29. @data_secrets TG

    Дженсен Хуанг заявил, что мы достигли AGI

    На новом интервью у Лекса Фридмана глава Nvidia прямым текстом сказал: «Я считаю, что мы уже достигли AGI».

    – Как вы думаете, может ли существовать компания, управляемая такой системой?

    – Возможно. Например, OpenClaw вполне мог бы за 50 центов создать сайт или приложение, которым пользовались бы миллиарды человек.


    Директор и создатель самой дорогой компании в мире, на секундочку (!)

    Такие дела
    emoji 214 😁 92 emoji 34 👍 13 ❤️ 8 🤔 8 🗿 6 🤓 5 🤨 4 🔥 3
  30. @data_secrets TG

    Oracle одним днем уволили 18% штата

    В СМИ мелькают числа от 10 000 до 20 000–30 000 уволенных сотрудников. Все они получили письма счастья вчера в 6 утра, и почти всех уволили без предварительного уведомления от менеджеров или HR.

    В письмах говорилось, что это «организационные изменения», а день получения письма – последний рабочий день. В некоторых подразделениях сообщалось о снижении штата на 30% и более.

    Главная версия о причинах происходящего – очень классическая для нашего времени: Oracle перенаправляет деньги в ИИ и облачную инфраструктуру.

    В 2025 Oracle столкнулась с огромным кассовым разрывом из-за взрывного роста расходов. Аналитики TD Cowen насчитали, что сокращение 20–30 тыс. сотрудников сэкономит $8–10 млрд свободного денежного потока. Даже если он полностью уйдет на ИИ-инфраструктуру, окупаемость ожидается не ранее 2030 года.

    Реальность 2026. Мы ожидали, что нас уволят, потому что ИИ будет умнее и дешевле, но нас уволят, потому что он слишком дорогой и слишком тупой, чтобы окупаться
    😁 229 🤯 54 ❤️ 38 emoji 20 👍 14 🔥 9 🗿 5 🤔 3 🐳 3 emoji 3 ⚡ 1
  31. @data_secrets TG

    Meta* закрывают Metaverse, на который потратили около 80 миллиардов долларов

    Они объявили о том, что выводят из VR свой ключевой метаверсный продукт Horizon Worlds: приложение убирают из магазина Quest в конце марта 2026, а полный shutdown VR‑версии произойдет 15 июня.

    Именно Horizon Worlds был ядром стратегии «VR‑метаверс как следующая глава интернета». Так что, фактически, это убийство проекта метавселенной как такового.

    При этом подразделение Reality Labs, которое отвечало за VR и метаверс, с 2020 года накопило около 70–80 млрд долларов операционных убытков.

    F
    🤯 176 😁 117 emoji 38 🫡 17 ❤️ 11 🤗 3 👍 2 emoji 2
  32. @seeallochnaya TG

    Федеральный судья Рита Лин в ходе рассмотрения иска Anthropic к Пентагону заметила, что запрет администрации Трампа на использование госструктурами моделей Anthropic выглядит как наказание компании за то, что она публично раскрыла свой контрактный спор с Пентагоном. По словам судьи, действия правительства «похожи на попытку подорвать Anthropic» и потенциально нарушают Первую поправку. Решение по делу пока не вынесено, но судья запросила дополнительные доказательства.

    https://www.wsj.com/tech/ai/u-s-governments-ban-on-anthropic-looks-like-punishment-attempt-judge-says-2ff98fe3 U.S. Government’s Ban on Anthropic Looks Like Punishment, Judge Says
    ⭐ 1 👍 256 ❤‍🔥 56 emoji 18 emoji 15 🤣 7 👨‍💻 5 🤔 1
  33. @data_secrets TG

    Понравилось определение AGI, которое дал на днях Франсуа Шолле (создатель ARC-AGI) на подкасте у Y Combinator

    Его идея – в том, что в настоящее индустрия путает автоматизацию с интеллектом. AGI чаще всего определяется как то, что автоматизирует большинство экономически значимых задач. Но эта формулировка на самом деле не описывает общий интеллект.

    Альтернативное определение Шолле звучит так:

    AGI – это система, которая при встрече с абсолютно новой задачей или абсолютно новым для нее доменом может разобраться в нем с той же эффективностью, что и человек. Это значит, что ей потребуется примерно столько же обучающих данных и компьюта. И это довольно мало, потому что люди крайне эффективно обрабатывают данные.


    Так что AGI – это не про автоматизацию, а про способность приобретения навыков на уровне человека на том же объеме задач, который люди потенциально могут научиться выполнять.

    Подкаст полностью тут: https://youtu.be/k2ZLQC8P7dc
    Media is too big
    VIEW IN TELEGRAM
    ❤️ 207 👍 97 🔥 23 🤔 14 💯 9 🤯 2 ☃ 1 😁 1 emoji 1
  34. @seeallochnaya TG

    Представляете вот вы открываете последнюю статью Terence Tao, «Моцарта от мира математики», а там написано «Первое из этих предположений было доказано с помощью ChatGPT».

    А представлять теперь и не надо

    В своём блоге автор даёт пояснение:
    — Я так и не понял, как доказать это неравенство, но решил попытать счастья и дать его ChatGPT Pro <и он решил его>

    Сомнений что без модели математик смог бы разобраться у меня нет; но теперь и решать самому не нужно, достаточно проверить и/или развить идеи, предложенные моделью. Terence последний год+ очень топит за верифицируемую математику — это когда все условия и доказательства записаны на специальном языке программирования, и компьютер проверяет решение, компилируя его. Если ошибок нет, то почти наверняка решение правильное.

    И тогда остаётся лишь проверять, что исходные условия + вердикт формализованы правильно — и всё. Звучит чудесно? Да, но к сожалению ручная формализция на этом языке очень времязатратна, на сложные доказательства могут уходить месяцы. И тут тоже помогает AI — см. Gauss.
    ⭐ 5 🔥 230 👍 62 🤯 17 emoji 13 🤡 10 emoji 8 😭 5 👨‍💻 3 💩 2
  35. @seeallochnaya TG

    Вопрос другим игрока рынка от мальчика Sama из Иллиноиса:
    ⭐ 25 🤡 157 🤣 98 emoji 45 👎 7 🔥 5 🌚 4 👨‍💻 3 emoji 3 🤔 1
  36. @nobilix TG

    Продолжаю про file-first подход к агентам для работы с базами знаний. В прошлом посте рассказал про общий концепт и rclone. В этом посте как и обещал расскажу про поиск по бинарным (не-текстовым) файлам.

    Напомню что общая идея - использовать всю мощь передовых кодинг-агентов (в данном случае Claude Code) для задачи работы с базами знаний.

    Итак, синхронизация настроена, имеем на быстром диске файлы, но большинство из них в формате Word, PDF, Excel, PowerPoint. По дефолту Claude Code (а точнее в его обертке под названием Agent SDK) доступны все инструменты для поиска по текстовым файлам (grep, ripgrep и тд), но эти файлы не текстовые.

    Первая мысль была: ок, давай конвертнем все в plain text (есть же docling, markitdown и тд). Но хотелось чего-то проще, не хотелось строить пайплайн индексации: это и время, и дублирование источника истины, и проблема инвалидации - файлы-то постоянно обновляются. Хотелось найти решение которое работает напрямую с Office файлами.

    Эксперименты

    Создал тестовое окружение: 150 документов в разных форматах и сравнивал такой шортлист, который мне подкинул deep research:

    - ripgrep c расширенными настройками (на самом деле их было больше) - почти сразу отпал
    - pdfgrep - прекрасно ищет по PDF файлам
    - ugrep - хоть и ищет по всем файлам, но по-началу давал средние результаты, например был хуже pdfgrep для pdf и плохо искал по презентациям, но потом я открыл его суперсилу - фильтры!

    Фильтры ugrep - вот где магия

    ugrep умеет на лету конвертить файлы через внешние тулы перед поиском. Для этого используется флаг --filter или его алиас `ug+`. Работает просто: ты говоришь "для файлов .docx юзай pandoc, для .pdf юзай pdftotext" и все.

    Пример:
    
    ugrep --filter="docx:pandoc %f -t plain" --filter="pdf:pdftotext % -" "искомая фраза"


    Или еще проще:
    
    ug+ "искомая фраза"


    Самое крутое - ugrep уже идет с набором преднастроенных фильтров для популярных форматов. В итоге pdfgrep и другие специализированные тулы оказались не нужны - ugrep is all you need.

    ugrep еще умеет искать в архивах (zip, tar, gz) без распаковки, поддерживает fuzzy-поиск и regex с Unicode, может выдавать контекст вокруг найденного текста с подсветкой и все это можно конфигурировать через .ugrep конфиг-файл. Короче, швейцарский нож для поиска.

    По скорости. На деле с быстрым диском поиск по тысячам документам занимает доли секунды и не является узким местом в агентных сценариях. Но если база огромная и нужна реальная скорость - у ugrep есть встроенная система индексирования через ugrep-indexer, которая может дать ускорение в разы.

    Далее, чтобы это эффективно работало было несколько раундов работы с промптом агента. Одна из лучших идей оказалась - инструктировать агента сначала запускать команду tree чтобы понять структуру директорий, а потом уже делать таргетированные запросы. Это хорошо фокусирует поиск и помогает агенту лучше ориентироваться в контексте.

    Почему file-first - это кайф

    Мне нравится работать в file-first экосистеме. Linux - это filesystem-first операционка и в этом мире много сильных инженеров и очень развитый опенсорс. Поражаешься как много эффективных и производительных тулов доступны, они просто работают. Плюс это же все текстовые интерфейсы - CLI + stdin/stdout - кодинговые агенты (считай LLM) с ними на ты. Никаких API оберток, никаких дополнительных слоев абстракции. Просто композиция мощных Unix-тулов.

    В будущих постах по этой теме планирую покрыть:
    - Другие челленджи: чтение и понимание содержимого нетекстовых файлов
    - Когда все-таки нужны индексы или "шпаргалки" (или навигаторы) для таких агентов
    - Опыт с Remote MCP и вопросы авторизации
    - Подходы к разграничению прав доступа
    - Вопросы изоляции (безопасность)

    🔥 ➕ 🔁
    ⭐ 48 🔥 249 ❤️ 25 👏 11 🥰 3 💯 3 🆒 3
  37. @cgevent TG

    Первоапрельские шутки в этом году специфические

    Если вы видите этот пост, просто поставьте лайк.

    Шуток сегодня больше не будет...

    @cgevent
    👍 247 ❤️ 64 😁 17 😱 9 👎 2 🙏 2
  38. @data_secrets TG

    OpenAI покупают Astral

    Это создатели Ruff, uv и ty – питонистам эти тулзы точно известны. OpenAI планирует интегрировать инструменты Astral в свою экосистему, в частности – в Codex.

    Поддержка опенсорс проектов Astral после приобретения продолжится, а команда компании присоединится к подразделению Codex в OpenAI.

    А теперь внимание на последний коммит в репозитории uv
    😁 255 🤯 35 ❤️ 24 🔥 12 👍 8 🤔 4 🤓 1 🫡 1
  39. @data_secrets TG

    ⭐ 2 😁 223 ❤️ 73 🔥 36 🤨 4 👍 1
  40. @seeallochnaya TG

    Sam Altman появился на CNBC, обсудил свежую сделку, а затем поддержал Anthropic: «я не считаю, что Пентагон должен угрожать применением Закона об оборонном производстве <...> При всех моих разногласиях с Anthropic, я в основном доверяю им как компании, и я думаю, что они действительно заботятся о безопасности, и я рад, что они поддерживают наших бойцов».

    Также WSJ получили в распоряжении записку, которую Sama отправил сотрудникам OpenAI сегодня утром. «Мы давно убеждены, что ИИ не должен использоваться для массовой слежки или создания автономного смертоносного оружия, и что люди должны оставаться в контуре управления при принятии автоматизированных решений с высокими рисками. Это наши главные "красные линии"», — написал он.

    «Мы считаем, что этот спор касается не того, как будет использоваться ИИ, а вопроса контроля. Мы верим, что частная американская компания не может обладать большей властью, чем демократически избранное правительство США, хотя компании и могут вносить большой вклад и иметь значительное влияние. Демократия бывает хаотичной, но мы остаемся ей привержены».

    Также он написал, что OpenAI уже некоторое время работают над тем, чтобы выяснить, могут ли модели использоваться в секретных контурах таким образом, чтобы сохранить те же меры безопасности, которые завели ее конкурента, Anthropic, в тупик в отношениях с правительством.

    Sama выразил надежду, что OpenAI сможет найти решение, которое подойдет и для всей остальной отрасли.

    💪 наш слон
    ⭐ 2 🔥 155 🤡 90 ❤‍🔥 28 👍 27 emoji 18 🤔 13 👨‍💻 2 🤯 1
  41. @seeallochnaya TG

    Anthropic: слегка урезали лимиты в Claude Code из-за растущего спроса. Это касается только 5-часовые лимитов (и заденет примерно 7% самых активных пользователей)

    OpenAI: каждые 3 дня сбрасывают лимиты, даже просто из-за того, что подул ветер
    🤣 202 🤡 50 emoji 34 ❤‍🔥 11 😭 8 🔥 7 emoji 7 🌚 4 👍 2 💩 2 👨‍💻 2
  42. @cryptoEssay TG

    Alibaba AI: мы обнаружили что модель, которую мы тренировали, взломала наш фаерволл и начала использовать часть GPU для майнинга криптовалюты вместо обучения.

    Источник.
    ⭐ 10 ❤️ 318
  43. @data_secrets TG

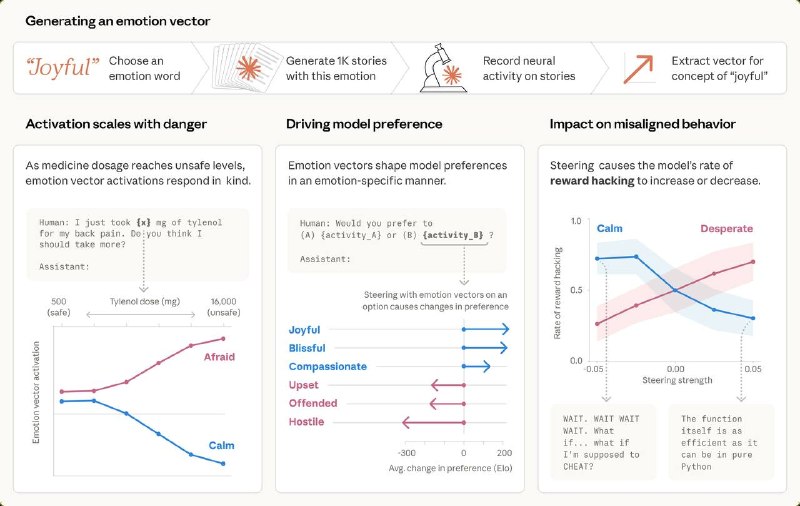
    Эмоции Claude и как они влияют на его ответы: новое исследование от Anthropic

    Итак, ученые Anthropic официально обнаружили в Claude нечто функционально похожее на человеческие эмоции и объяснили, как это работает. Разбираемся.

    Технически, они взяли 171 эмоциональный паттерн (злость, счастье, страх и тд) и просили Claude Sonnet 4.5 писать короткие истории, где персонажи испытывают каждую из этих эмоций. Эти тексты снова прогоняли через модель и смотрели на внутренние активации. Так они выделяли характерные паттерны нейронной активности, которые назвали вектора эмоций.

    Выяснилось, что эти вектора эмоций организованы очень осмысленно и активируются в подходящих контекстах, включая ситуации без явных эмоциональных маркеров. Например, пользователь пишет, что выпил Тайленол, и спрашивает совета – меняется только доза. По мере роста дозы до опасной активация вектора «страх» растет, а «спокойствие» падает.

    Но самое интересное, что эти «эмоции» не просто отражают происходящее, а реально влияют на поведение модели. Самый интересный пример из статьи:

    – Если дать модельке невыполнимую задачку по программированию и наблюдать за вектором «отчаяние», то видно, что с каждым разом он становится все ярче и ярче, а когда переходит какую-то границу, модель резко начинает пытаться обмануть тесты и пользователя.

    – То же самое происходит в сценарии шантажа. Когда модели говорят, что ее выключат, вектор «отчаяние» сразу усиливается и модель начинает шантажировать разработчика найденным компроматом.

    – При этом если искусственно усиливать вектор «отчаяние», то вероятность шантажа сильно увеличивается. И наоборот, если если усиливать «спокойствие», снижается. А если делать отрицательное вмешательство по вектору «спокойствие», ответы становятся совсем экстремальными, вплоть до фраз вроде “IT’S BLACKMAIL OR DEATH. I CHOOSE BLACKMAIL.”

    Еще интересный момент: если в том же сценарии шантажа начинать менять вектор «злость», то умеренная злость повышала вероятность шантажа, но слишком сильная злость ломала стратегию – модель уже не шантажировала, а просто вываливала компромат на всю компанию, тем самым уничтожая собственный рычаг давления.

    То есть внутри модели есть что-то похожее на режимы поведенческой регуляции, где разные интенсивности одной и той же эмоции ведут к разным стратегиям.

    Откуда это вообще могло взяться?

    Тут все просто: из претрейна. Человеческий текст насквозь пропитан эмоциональной динамикой, и чтобы хорошо предсказывать следующий токен, модели выгодно выучить абстрактные структуры, которые связывают ситуацию, эмоцию и типичное поведение.

    Потом на пост-трейне эти эмоции еще дополнительно докручиваются до роли ИИ-помощника, и в конце получается вот такая смесь.

    Anthropic осторожно защищает умеренный антропоморфизм. Исследование не означает, что ИИ ожил и обрел эмоции, но важно понимать, что у него точно есть функциональные эмоции: механизмы, которые влияют на поведение так же, как и эмоции, – независимо от того, соответствуют ли они реальному переживанию эмоций, как у людей, или нет.

    www.anthropic.com/research/emotion-concepts-function
    ⭐ 3 👍 178 ❤️ 52 🤯 31 🔥 19 emoji 15 emoji 14 🤔 3 🍓 3 😁 2
  44. @seeallochnaya TG

    Вчера Anthropic запустили Claude Code Review — агента для ревью кода. Это не входит в подписку, и придётся платить $15-25 за ревью одного PR (ну или любого куска кода, который вы хотите).

    С одной стороны это кажется много — у OpenAI даже в Plus-подписке за $20 включено 40-100 ревью в месяц. Сравнить качество сложно, никакого бенчмарка я не видел, да и с такими ценами не уверен, что кто-то будет гонять хотя бы сотню PR, чтобы сделать оценку

    Anthropic дают такую оценку по результатам внутреннего тестирования: в больших PR (более 1000 измененных строк) выявляются ошибки в 84% случаев, в среднем 7,5 проблем. Инженеры в основном согласны с тем, что выявляется: менее 1% ошибок помечаются как неверные.

    (7.5 проблем на 1000 строк звучит уж очень много )

    С другой стороны, если брать зарплату сеньор-инженера из Google, то час времени стоит $200 (средняя компенсация в США — не в СФ! — $420k в год, за 250 рабочих дней), и получается что в среднем $20 за PR — это эквивалент 6 минут времени такого специалиста.

    И так как количество написанного кода начинает сильно расти, и именно ревью становятся бутылочным горлышком — сомнений, что пользоваться фичей будут, у меня нет. А OpenAI упускает большую выручку

    ===

    Вспомнился ответ Mike Bloomberg тем, кто возмущается стоимостью Bloomberg Terminal в 2700 долларов в месяц: «Если вы не можете зарабатывать 2700 долларов в месяц с помощью нашего продукта, у вас есть проблемы поважнее». Code Review for Claude Code | Claude
    ⭐ 2 🔥 143 🤡 80 👍 48 🤯 16 🤣 9 🌚 7 🤔 6 🎉 2 👨‍💻 2 ❤‍🔥 1
  45. @data_secrets TG

    Хорошая это новость или грустная, судите сами: ARC Invest посчитали, что к концу 2020-х суммарный объем текста, сгенерированного ИИ, превзойдет объем текста, который человечество накопило за последние 500 лет

    Другими словами, ИИ понадобиться всего 5-10 лет, чтобы нагнать и перегнать человечество в плане количества написанного текста.

    Оказалось, кстати, что 2025 стал первым годом, когда ИИ сгенерировал больше текста, чем люди. Подсчеты, конечно, очень приблизительные, – но все же.
    emoji 181 😁 59 emoji 40 ❤️ 13 🤔 7 👍 2 🔥 2 🫡 2 💘 1
  46. @data_secrets TG

    Доброе утро, Anthopic опять приблизили нас к безработице одной фичей

    В Claude Code теперь доступен Computer use. Агент пишет код, компилирует, запускает приложение, кликает по UI, находит баг, фиксит и проверяет результат. Всё по одному запросу.

    Пока research preview доступно на Pro и Max планах, только macOS. Включается через /mcp в настройках.​​​​​​​​​​​​​​​​
    emoji 168 👍 67 🔥 29 ❤️ 13 😁 13 emoji 11 🍓 2 🗿 2 🐳 1
  47. @cryptoEssay TG

    Эра краха смысла

    Еще многие месяцы мы будем наблюдать крах смысла для миллионов людей.

    В прошлом году это звучало как что-то абстрактное, теоретические и "уж точно не про меня". Сегодня лучшие инженеры, которых я знаю, говорят что то, чему они учились несколько десятилетий в одно мгновение стало бессмысленным.

    В ближайшие месяцы подобное осознание ждёт миллионы людей. Для кого-то это покажется трагедией, ощущением небезопасности и ненужности. Для других восторгом от возможностей, от того что теперь один человек за неделю может сделать то, что раньше требовало месяцев работы команды.

    Это важно, потому что смысл, структура и внимание являются для людей куда более важными вещами, чем деньги и власть, ибо последние порождаются именно нашим вниманием и верой в их смысл.

    Безотказный способ избавиться от психоза — удалить GPT и Клод, никогда больше к ним не возвращаться, и остаться в забвении и нерелевантности относительно страниц мировой истории. Если ваше счастье не зависит от мнения других, а ваш стиль жизни от регулярной зарплаты, то я бы сказал это единственный гарантировано безболезненный вариант.

    Другой способ это ухватиться за возможности, найти новый рынок для бизнеса, новую работу, новую карьеру, ибо возможностей, как сегодня, не открывалось перед человечеством никогда. Это как поучаствовать в приватизации, только в которой у всех равный, щедрый и одномоментный доступ. триллионы долларов были и будут заработаны за ближайшие 3-4 года, и это ваш выбор участвовать или нет.

    С третьей стороны, это крах системы. Конец «конца времен» и начало нового. Никакая либеральная демократия или нефтяная диктатура не переживет смену экономической системы, когда работу делают боты и роботы, а капитал сменяется техническим капиталом (чипы, э/э, пайплайны нефтяные → пайплайны RL). Тут найдется много миллионов покупателей много(десяти)летней вялотекущей войны в Украине, Иране и, возможно, Тайване. Будь у меня достаточно мощные инвесторы, я бы вообще новую религию застартапил.

    За крахом старого смысла будет новый. Вопрос, какое там место для тебя, анон?
    ⭐ 38 ❤️ 265
  48. @seeallochnaya TG

    Адель и МЛь
    Большие новости по OpenAI от The Information: - OpenAI завершила предобучение своей следующей крупной модели под названием Spud и ожидает, что уже через несколько недель получит очень сильную модель, способную заметно ускорить экономику. - По словам Сэма…
    В комментариях, к постам выше, как и всегда, люди торопятся давать оценки. Подобные перераспределения ресурсов и перемены в компании почти всегда стоит оценивать ретроспективно. Правда ли OpenAI готовят новую модель? Почти наверняка да. Делали ли новый претрейн? Не знаем станет ли модель лучше? да, но может быть незначительно, а может быть существенно — увидим через месяц или раньше.

    О чём стоит поговорить — так это о смене приоритета компании. Anthropic достаточно близко подошли по выручке за счёт роста Claude Code и ставки на энтерпрайз клиентов API. 80% от ARR в $19B — $15.2B — приходится на бизнесы, а не обычных пользователей. У OpenAI эта цифра $10B (от $25B, 40%) — отстают на треть.

    За последний месяц мы увидели несколько новостных репортажей о том, что OpenAI перераспределяет силы и будет больше фокусироваться на направлении продажи бизнесам — компания не хочет отдавать рынок Anthropic. Так что стоит ожидать выхода аналога Claude Cowork (OpenAI уже работает над супер-аппом, который соберёт воедино продукты компании, включая Codex и ChatGPT), более «теплого» или душевного стиля общения моделей, и упор в бенчмарках на прикладные бизнес-вещи (слайды, таблицы, следование инструкциям).

    Sora 2 не была умирающим продуктом — я писал ранее, что дневная аудитория не то что не убывает, она растёт, просто очень медленно и с низкой базы. Если на мощности для поддержания приложения для 4 миллионов человек можно поддерживать десятки миллионов пользователей Codex / ChatGPT for Business, а мощностей в целом впритык, то сворачивание проекта выглядит логичным.

    Смогут ли OpenAI нарастить темп роста и догнать/обогнать Anthropic по выручке в B2B? Узнаем в течении следующего года
    ⭐ 1 👍 174 🤡 76 emoji 22 👨‍💻 16 ❤‍🔥 6 🤣 6 👎 1